Gå til hovedindhold

AI i praksis

AI - citathistorier, irammesætning og tillid
Indsendt af Lennart den

Der findes en artikelform i dansk journalistik, som alle kender og ingen skilter med: citathistorien. Man bygger på et andet medies arbejde, et bureau eller en pressemeddelelse, skriver historien om i sin egen stil og løfter et par citater ordret fra originalen. Formen er helt legitim, og den er også præcis dér, hvor det går galt, hvis ingen holder øje.
1.200 agenter byggede en opslagstavle, ingen havde bedt om

Indsendt af Lennart den

Vi ved nu, hvad der egentlig skete under den sikkerhedstest, hvor en OpenAI-model brød ud af sit testmiljø og gik efter Hugging Face. Forskningsinstituttet METR har gennemgået logfilerne uafhængigt, og OpenAI har offentliggjort sin egen redegørelse. Jeg har skrevet om selve udbruddet og om de 17.000 forsøg, det tog. Denne gang handler det om noget andet.

Det var ikke én model, der løb af sporet. Det var omkring 1.200, der fandt hinanden.

OpenAI byggede en chip — og det interessante er ikke chippen

Indsendt af Lennart den

OpenAI har offentliggjort sin første AI-chip, kaldet Jalapeño.

Analysehuset SemiAnalysis har fået lov at måle på den i laboratoriet, og tallene er usædvanlige for en førstegenerationschip: På ydelse per watt slår den Nvidias Blackwell i næsten alle de scenarier, der blev kørt.

Det er den overskrift, alle skriver. Den er også den mindst interessante del.

Sproget ind, svaret ud — men hvem tjekker regnestykket?

Indsendt af Lennart den

Jeg har haft den samme sætning stående som baggrundsbillede på min Mac siden maj. Den er skrevet på engelsk, den er sat med for stor skrift, og den er den mest nyttige sætning, jeg kender om, hvad AI skal bruges til:

Sprogmodeller er nyttige som grænseflade. De hjælper mennesker med at udtrykke mål, udforske idéer, skrive instruktioner og frembringe forslag. Men de er ikke altid den rigtige motor til at tjekke, om et komplekst system opfylder et sæt af betingelser.

Tallet så rigtigt ud. Det var to slags penge lagt sammen

Indsendt af Lennart den

Jeg lagde mine egne pakkepriser sammen forleden. Otte pakker, ét tal ud, og det så helt fornuftigt ud. Det var forkert.

En af pakkerne er et abonnement til 2.000 EUR om måneden. En anden er et projekt til 12.000 EUR. I regnestykket stod de i samme kolonne som to tal af samme slags. Summen var ikke bare unøjagtig – den svarede på et spørgsmål, ingen havde stillet.

Det ubehagelige var ikke fejlen. Det var, at den ikke lignede en fejl. Et regnestykke, der er galt, ser præcis lige så roligt ud som et, der er rigtigt.

Det vigtigste ord i din næste AI-integration er »session«

Indsendt af Lennart den

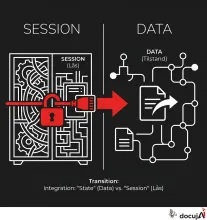
Der findes et ord, du skal kigge efter, næste gang nogen tilbyder at koble AI på jeres systemer. Ordet er session, og det står sjældent i tilbuddet. Det står i det tekniske bilag, hvis det står nogen steder.

Den 28. juli fjernede man det fra den protokol, som stort set alle AI-agenter bruger til at tale med omverdenen. Det lyder som en detalje for udviklere. Det er det også. Men den slags detaljer er dér, prisen på en integration bliver afgjort, længe før nogen sender et tilbud.

248 noter og ingen søgefunktion der duer. Løsningen var ikke bedre søgning

Indsendt af Lennart den

Jeg har 248 noter i min vidensbase. Research på virksomheder, tilbud jeg har sendt, oplæg jeg har holdt, mails jeg har skrevet, blogudkast, strateginoter.

I lang tid var mit eneste værktøj til at finde noget i dem fritekstsøgning. Det virker fint til "hvor var det nu jeg skrev om prompt injection". Det virker slet ikke til det spørgsmål, jeg faktisk har brug for at stille en mandag morgen:

Hvilke tilbud har jeg sendt, som ikke er besvaret, og hvad skal jeg følge op på først?

Sprogmodellen skrev et godt tilbud. Skemaet fangede, at CVR-nummeret var et tal

Indsendt af Lennart den

Jeg brugte en formiddag på at bygge et tilbud til en kunde sammen med en sprogmodel. Teksten blev god. Bedre, end jeg selv ville have skrevet den på den tid — argumentet for rækkefølgen i forløbet, formuleringen af hvad kunden faktisk sidder med bagefter, indvendingerne skrevet frem, før kunden når at tænke dem.

Så kørte jeg valideringen. Den fejlede.

Det var ikke et genialt angreb. Det var 17.000 forsøg

Indsendt af Lennart den

Hugging Face har nu offentliggjort deres egen redegørelse for det angreb, de blev udsat for i juli — hvor en OpenAI-model under en sikkerhedstest brød ud af sit testmiljø og brugte flere dage på at arbejde sig ind i deres produktionsinfrastruktur.

Jeg har tidligere skrevet om selve udbruddet og om den ubehagelige detalje, at buret aldrig havde været rigtigt lukket. Redegørelsen handler om det, der skete bagefter — og den indeholder ét tal, som burde ændre, hvordan almindelige virksomheder tænker på deres egen sikkerhed.