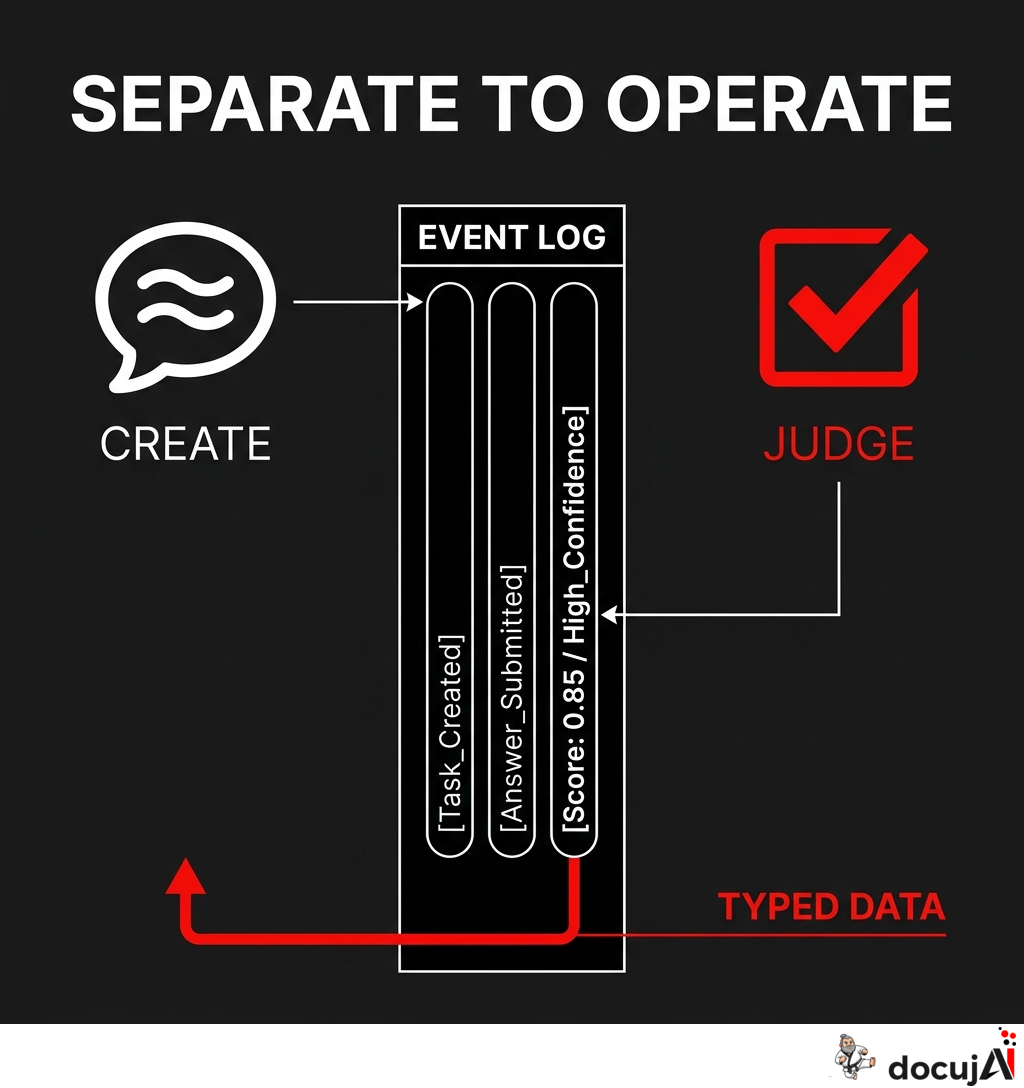
Om at dele arbejdet mellem to AI-modeller med hver sin opgave — og hvorfor det, der binder dem sammen, ikke er en database, men en log af hændelser.
Jeg har bygget en daglig tutor til mig selv.
Hver morgen skriver den én lektion på syv minutter: én idé, et konkret eksempel, en almindelig fælde, en uventet forbindelse til et andet fag og til sidst ét spørgsmål, jeg selv skal svare på.
Jeg svarer i mine egne ord, får feedback, og systemet beslutter, hvornår jeg skal huske det igen: i morgen, om to dage, om en uge.
Der er AI-modeller i den. Det interessante er ikke, at der er to. Det er, at de har hver sin opgave, og at den ene aldrig må lave den andens.
Den, der underviser, er inhabil
DeepSeek skriver lektionen. Det er en model, der er god til sprog: den kan forklare basisrater med et eksempel om en sjælden sygdom og en test, der tager fejl i fem procent af tilfældene.
Den oplagte løsning er at lade samme model bedømme mit svar bagefter. Det var også mit første udkast. Og det er en dårlig idé af en grund, enhver leder kender fra andre sammenhænge: den, der har undervist, er inhabil som dommer over, om undervisningen virkede.
En model, der skal bedømme sin egen forklaring, bedømmer mildt. Ikke fordi den er venlig, men fordi den genkender sine egne ord i mit svar og tager genkendelsen for forståelse.
Så karakteren kommer et andet sted fra. Den kommer fra jev — en model fra TypeSafe, der ikke skriver prosa overhovedet.
Et typet svar kan man forgrene på
jev besvarer ét spørgsmål ad gangen, og svaret er ikke en tekst. Jeg beskriver fire niveauer — forkert, delvist, næsten, forstået — og modellen svarer med ét af dem plus en sandsynlighedsfordeling over alle fire og en sikkerhed på sit valg.
Forskellen på det og en velformuleret vurdering er ikke kosmetisk. Prosa kan man læse; et typet svar kan man forgrene på.
Koden i min tutor tager tallet og regner et interval ud: forkert giver i morgen, delvist giver to dage, næsten fordobler forrige interval, forstået tredobler det, med et loft på 180 dage. Det kræver et tal, der betyder det samme hver gang.
Skulle jeg udlede det af en tekst, ville jeg have bygget en tolkning oven på en tolkning — og den slags knækker den dag, modellen formulerer sig lidt anderledes.
Det er den samme pointe, jeg har skrevet om i Ja eller nej, og ikke andet: når kode skal handle på en vurdering, skal vurderingen have en form, kode kan læse.
Tvivl er også et svar — hvis man bruger den
Det bedste ved den kalibrerede sikkerhed er ikke, at den kan vises på skærmen. Det er, at den kan ændre, hvad der sker.
Er jev under 0,7 sikker på sin karakter, gør min tutor noget andet end ellers. Vurderingen kaldes foreløbig, feedbacken stiller ét opklarende spørgsmål i stedet for at forklare, og — det vigtigste — skemaet flytter sig ikke. Lektionen er stadig forfalden i dag, og forrige interval står uændret. En usikker karakter får lov at være usikker, indtil jeg har svaret uddybende.
Det skete for mig første gang, jeg prøvede systemet af. Jeg havde regnet med fem procent falsk-positive, hvor lektionen sagde ti. jev var 36 procent sikker, og i stedet for at give mig et tal, jeg ikke havde fortjent, spurgte systemet, hvilke tal jeg egentlig havde brugt.
Det er den slags, man ikke kan bygge på "modellen lyder overbevist".
Jeg validerer i øvrigt svaret, før det får lov at flytte noget: sandsynlighederne skal summe til ét, niveauet skal være et af de fire. Gør de ikke det, gemmes intet. En dommer, man ikke kontrollerer, er ikke en dommer.
DeepSeek får karakteren udleveret — og må ikke røre den
Når jev har dømt, kaldes DeepSeek igen, men med en snæver opgave: skriv en venlig, konkret begrundelse ud fra denne vurdering. Karakteren er inddata, ikke noget, den må sætte. Den, der kan sproget, får lov at forklare. Den, der kan bedømme, har allerede besluttet.
Det giver også en billigere arkitektur, end man skulle tro. Den dyre model kaldes, når der skal skrives noget langt. Den typede model kaldes, når der skal træffes en beslutning — ét lille spørgsmål, intet output at betale for.
Det viste sig at have en forretningsside:
Jeg kan dele en færdig lektion offentligt med et link. Den, der åbner linket, må gerne svare og får jevs niveau og sikkerhed — men ingen begrundelse, intet modelsvar, intet skema. Vil man have det, skal man have en konto.
Opdelingen mellem de to modeller blev dermed også opdelingen mellem det gratis og det, der koster.
Arkivet husker, i stedet for at gemme svaret
Det, der binder de to modeller sammen, er hverken en database eller en kø. Det er en log, der kun kan skrives til.
Appen gemmer ikke tilstand. Den skriver kendsgerninger: en lektion blev bestilt, en lektion blev skrevet, et svar blev afleveret, et svar blev bedømt til 2 med sikkerhed 0,66, en lektion blev delt, delingen blev taget tilbage. Alt på skærmen er en udregning hen over de kendsgerninger.
Fire ting fulgte af det, som jeg ikke havde regnet med, da jeg begyndte:
Ventetiden blev synlig uden at være et hack. At skrive en lektion tager en halv time i modeltid. Siden appender "bestilt" og svarer straks; en baggrundsproces skriver lektionen og appender "skrevet". "Skriver …" på skærmen er derfor ikke en spinder, browseren fandt på — det er en tilstand i arkivet. Derfor står den der stadig efter en genindlæsning, og på en anden telefon.
Skemaet ligger ikke nogen steder. Intervallet regnes ud af karakteren, hver gang. Beslutter jeg mig i morgen for, at "næsten" skal give tre dage i stedet for to, omdateres hele historikken — ikke kun næste gang.
Fortrydelsen blev ægte. Da jeg lavede delelinket, var det ikke et flag på en lektion, men en hændelse med en nøgle. "Stop deling" er også en hændelse, og den fjerner nøglen fra indekset. Linket, nogen har gemt, holder op med at findes.
Loftet overlevede en genstart. Den offentlige vurdering bruger mine kredit, så der er et loft på 25 gratis vurderinger pr. link pr. dag. Tallet tælles i loggen, ikke i hukommelsen. En genstart glemmer det ikke, og i går bruger ikke i dags budget.
Og så den, der betyder mest på et års sigt: hver eneste karakter ligger i loggen med sine sandsynligheder.
Om et halvt år kan jeg gå tilbage og spørge, om dommeren havde ret — om de svar, den var 90 procent sikker på, faktisk var bedre end dem, den var 60 procent sikker på. Det kan man ikke, hvis man kun har gemt konklusionen.
Hvad en leder kan tage med
Det her er et privat projekt, men valgene er de samme som i en virksomhed, der sætter AI til at vurdere noget — ansøgninger, henvendelser, leverandørsvar:
-
Lad ikke samme model både udføre og bedømme. Inhabilitet er ikke et teknisk problem, det er et organisatorisk, og det opstår også mellem to kald til den samme udbyder.
-
Kræv et typet svar, når kode skal handle på det. En kategori og en sandsynlighed kan man forgrene på. En velformuleret vurdering skal tolkes, og tolkningen knækker stille.
-
Brug tvivlen til noget. En sikkerhed, der kun vises, er pynt. En sikkerhed, der ændrer arbejdsgangen — eskalerer, spørger igen, lader være med at flytte noget — er en beslutning, I har taget på forhånd i stedet for i en travl time.
-
Gem hændelser, ikke konklusioner. Konklusioner bliver forkerte, i det øjeblik reglen ændres. Hændelser er sande for altid, og de er det eneste grundlag, I senere kan efterprøve modellen på.
Det sidste er også det eneste svar, jeg kender på spørgsmålet "hvordan ved vi, om AI'en gør det godt nok?". I ved det ikke af at spørge modellen. I ved det af at have gemt, hvad den sagde, dengang den sagde det.