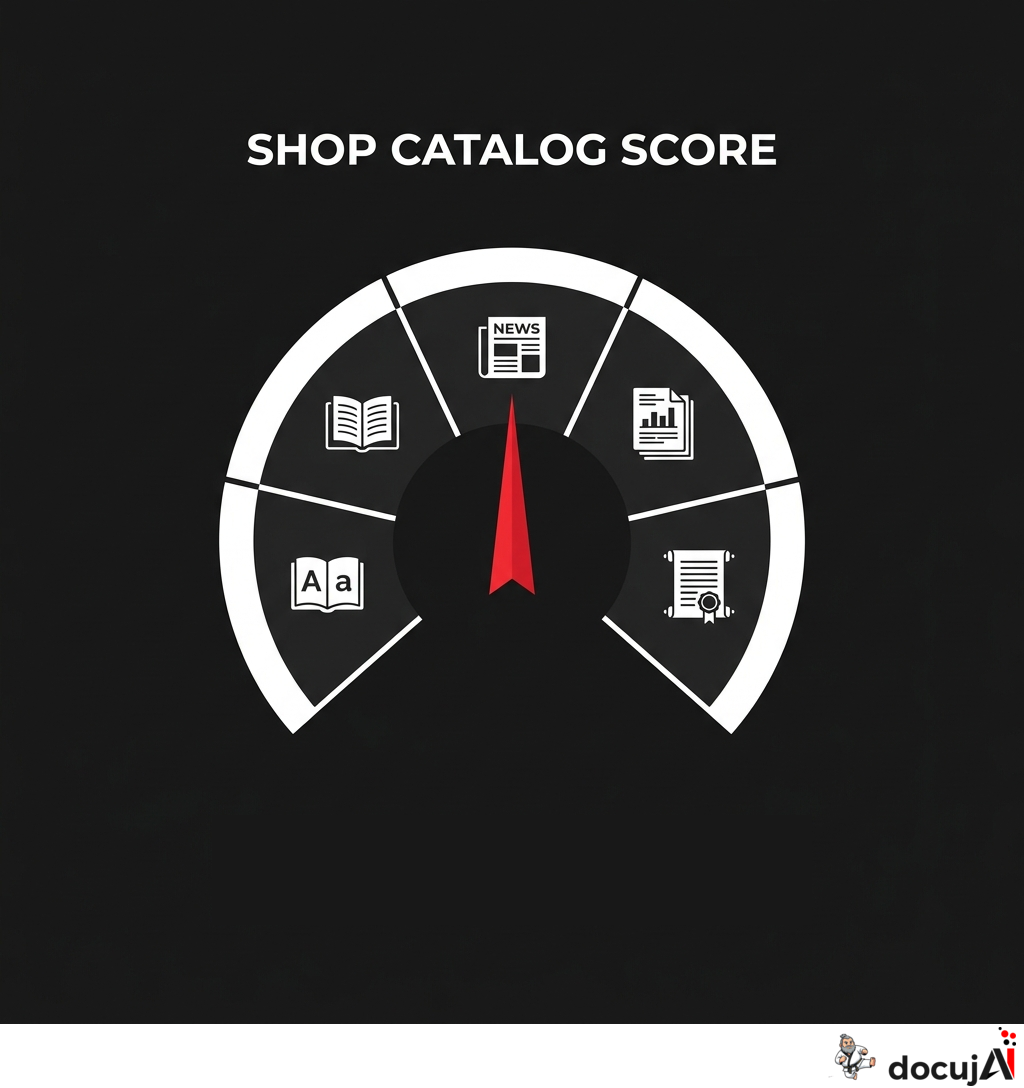
Indsæt adressen på en Shopify-butik, og Topify fortæller dig på et øjeblik, hvor tungt kataloget er at læse. Bag svaret ligger tyve års sprogarbejde, to slags AI og et regneværktøj skrevet i Rust.
Produktbeskrivelserne er de tekster, en webshop har flest af og læser færrest gange. De bliver skrevet én ad gangen, ofte af forskellige mennesker, og ofte ved at kopiere den forrige og rette lidt i den. Efter et par år har butikken hundredvis af tekster, som ingen har læst samlet.
Jeg har arbejdet med sprog det meste af mit arbejdsliv. Først som videnskabsjournalist, hvor en tekst skal kunne læses af andre end eksperter. Siden på Folkets Avis, hvor hver artikel bliver målt, før den udgives. Når jeg ser på en produkttekst, spørger jeg det samme, som jeg altid har spurgt: Hvem skal kunne læse den, og kan de?
Topify er mit forsøg på at stille det spørgsmål til et helt katalog på én gang.
Det første tal kommer, før kataloget er læst
Forsiden har ét felt. Man indsætter adressen på en butik og trykker. Browseren henter derefter butikkens offentlige produktkatalog, som alle Shopify-butikker udstiller uden login.
Det første, der kommer frem, er antallet af rækker. Det tal står i importen og kan vises, før serveren har læst en eneste produkttekst. Derefter kommer antallet af produkter, antallet af ord og ord pr. beskrivelse. Tallene tæller op på skærmen, efterhånden som de bliver klar.
Så kommer dommen. Kataloget bliver placeret på en skala med fem trin: Pixi-bog, Ugeblad, Avis, Fagbog og Doktorafhandling.
Skalaen bygger på LIX, det læsbarhedsmål, de fleste danskere har mødt i skolen. LIX lægger den gennemsnitlige sætningslængde sammen med andelen af lange ord. Under 25 er børnebøger. Over 55 er akademisk tekst og lovgivning. Jeg har valgt navnene, fordi »LIX 40« siger de fleste ingenting, mens »dit katalog læser som en avis« siger noget med det samme.
Den amerikanske skobutik Allbirds har 692 produkter og 7.457 rækker i sit katalog. Det læser som en avis, LIX 40. For en lille dansk butik med ti produkter kom hele rapporten på et halvt sekund på min egen maskine og på godt to sekunder på sitet.
Målene kommer fra en redaktion
LIX er ikke det eneste mål. Topify måler også, hvor meget sætningslængden varierer, hvor stor en andel af sætningerne der har 25 ord eller flere, og hvor mange ord der falder uden for de 10.000 mest brugte danske ord.
Det er de samme mål, vi bruger på Folkets, før en artikel går ud. Dér er de kalibreret mod de artikler, vi allerede har udgivet. I Topify er formlerne flyttet med uændret, så den samme tekst får det samme tal begge steder. Grænserne er derimod ikke flyttet med. En produkttekst er ikke en reportage, og jeg vil hellere vise tallet end dømme efter en målestok, der er lavet til noget andet.
Andre mål er hentet fra mit eget Nushell-værktøj til tekstanalyse, comma, og tilpasset produkttekster. Topify finder fraser, der går igen i mange beskrivelser, som »fri fragt ved køb over 500 kr.« midt i hver eneste tekst. Det finder beskrivelser, der næsten er ens. Det viser, hvilke ord der kendetegner hver kategori, og hvilke ord der kun bruges én gang, hvor stavefejlene typisk gemmer sig. Klikker man på et ord, får man alle de steder, det står, med ordene omkring.
Næsten ens tekster kræver et rigtigt regneværktøj
Den sidste type kræver mest regnekraft. For at finde beskrivelser, der næsten er ens, skal hver tekst i princippet sammenlignes med hver anden. Med 2.000 produkter er det to millioner par. Bygger butikken sine tekster over en skabelon, vokser det mellemregnede arbejde til omkring 140 millioner rækker.
Serverdelen af Topify er skrevet i Nushell, en kommandolinje og et programmeringssprog, der behandler data som tabeller frem for løs tekst. Nushell kan udvides med plugins, og polars er et af dem. Polars er et dataværktøj skrevet i Rust, bygget til at gruppere og sammenkæde store tabeller hurtigt.
Med polars bruger Topify en metode, der hedder MinHash. Hver tekst får et kort fingeraftryk, og kun tekster med lignende fingeraftryk bliver sammenlignet ordentligt bagefter. Et katalog med 2.000 skabelonbaserede beskrivelser bliver gennemgået på cirka to sekunder, og arbejdet vokser kun lineært med kataloget.
Første version fandt ingen dubletter i et katalog, hvor alle tekster var bygget over samme skabelon. Det var netop det tilfælde, der betød mest. Den næste version havde en regnefejl, der fik alle 48 fingeraftryk til at pege på den samme ordsekvens. Begge dele blev fanget af tests med kendte svar, før de nåede sitet. Det er en god grund til at skrive testen, før man stoler på tallet.
To slags AI med hver sin opgave
Tallene beregnes uden AI. Det er bevidst. LIX skal give det samme hver gang, og et mål, man ikke kan genregne, er svært at stole på.
AI kommer ind, når der skal skrives eller vurderes.
En sprogmodel, DeepSeek, kan rette, forenkle eller oversætte en produkttekst. Modellen får kun selve teksten, aldrig priser, varenumre eller andre felter. Svaret bliver kontrolleret, før det bliver vist. Ændrer modellen et tal, en webadresse eller en e-mailadresse, bliver forslaget afvist. Og intet kommer ind i kataloget, før et menneske har trykket på knappen.
Den samme model kan også trække produktets påstande ud som en liste: vandtæt, holdbar i ti år, lavet af genbrugsmaterialer. Den vurderer dem ikke. Listen gør det bare let for et menneske at spørge, om hver påstand kan dokumenteres.
Den anden AI er JEV fra TypeSafe. Den skriver ikke tekst. Den svarer på faste spørgsmål med en sandsynlighed. Passer titlen til beskrivelsen? Dækker metatitlen produktet? Indeholder teksten en påstand, der bør kontrolleres? Et tal kan bruges direkte i en arbejdsgang.
Jeg har tidligere skrevet, at AI også er sprogteknologi og ikke kun et IT-anliggende. Topify er det synspunkt omsat til et værktøj. Sprogfolkenes mål bestemmer, hvad der måles. AI'en får de opgaver, hvor den er god, og menneskerne har det sidste ord.
Det, vi lærte undervejs
Den første version hentede kataloget fra serveren. Fra min egen computer virkede det fint. Fra serveren i datacentret svarede Shopify med fejlkode 429, »for mange forespørgsler«, allerede ved de første forespørgsler og uanset butik. Alt tyder på, at Shopify begrænser trafik fra datacentre langt hårdere end trafik fra almindelige kunder.
Løsningen var at lade browseren hente kataloget. Shopify tillader det, og browseren har en almindelig brugers adresse. Serveren modtager kun de produkter, browseren har fundet, og kontrollerer, at de har Shopifys form, før de bliver til et katalog. En sidegevinst er, at serveren ikke selv henter adresser, som en fremmed har tastet ind.
Den anden lektie handlede om hastighed. Rapporten var først korrekt, men langsom: Alt blev regnet, før noget blev vist. Nu kommer de billige tal først, og de tunge målinger kører videre i baggrunden, mens en lille trinlinje krydses af. Når den er færdig, er hele analysen gemt, så næste side åbner med det samme.
Hvad det betyder for en webshop
En webshops tekster bliver læst af to slags læsere: kunder og søgemaskiner. Kunderne opgiver tekster, der er for tunge. Søgemaskinerne viser sjældent mere end én af flere tekster, der er næsten ens. Ingen af delene kan man se ved at læse én beskrivelse ad gangen.
Med Topify kan en ejer på et halvt minut se, hvor kataloget står, og hvor det halter. Topify kan lave et forslag til hver tekst, men ejeren beslutter selv, hvad der skal ændres.
Vil du vide, hvad din egen butik læser som, så skriv til mig. Og hvis den læser som en doktorafhandling, ved du, hvor du skal begynde.