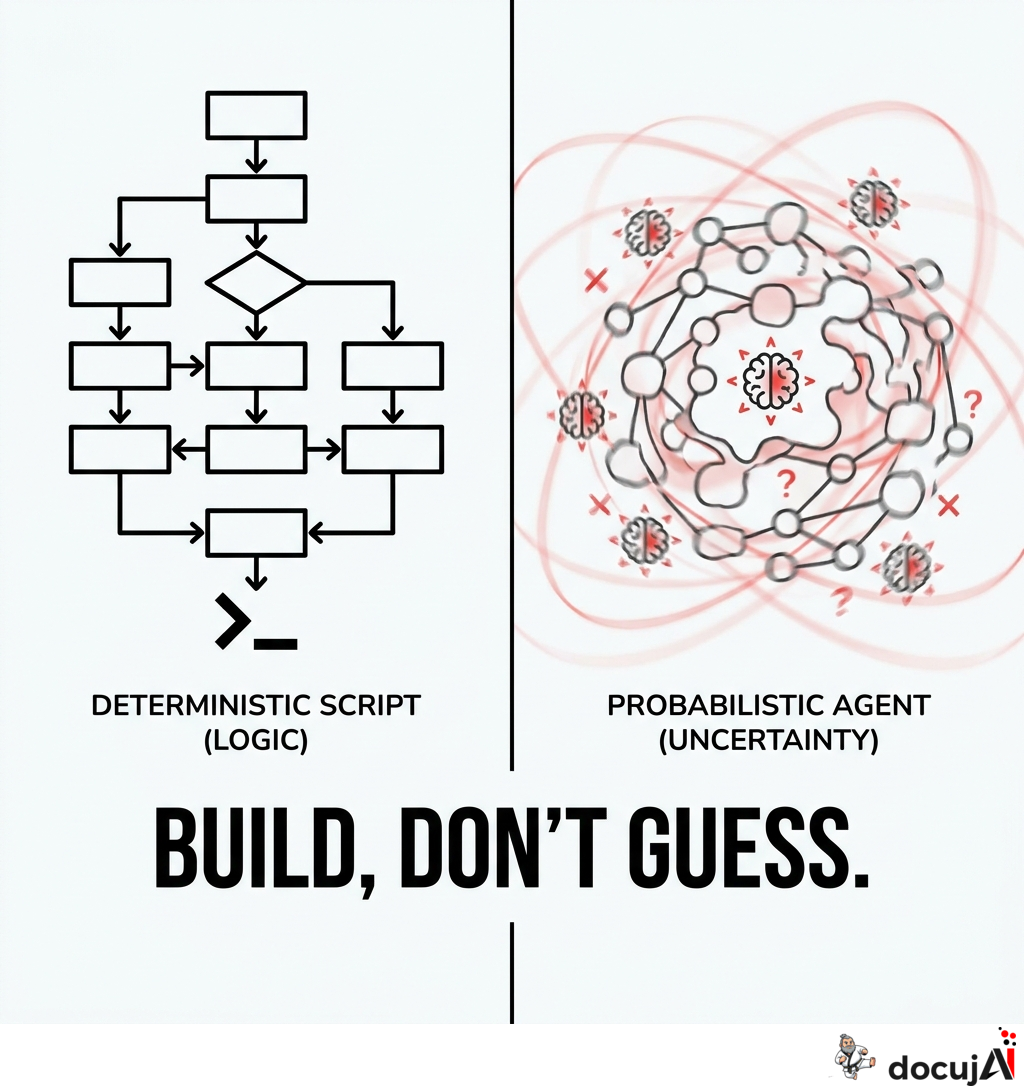
Hver morgen vil jeg gerne vide det samme: Hvad står der i kalenderen, hvilke opgaver forfalder, hvilke mails er ulæste, hvem jeg har lovet at ringe til, og hvilke fødselsdage der kommer. Det er præcis den slags opgave, der for tiden bliver solgt som en AI-agent. »Din personlige assistent læser din indbakke, tjekker din kalender og giver dig et overblik hver morgen.«
I går byggede jeg den selv. Den hedder brief, er 142 linjer kode og kører på seks sekunder. Den bruger ingen sprogmodel.
Hvad briefingen gør
Den henter fra otte kilder, som jeg i forvejen har kommandoer til:
- kalenderen og opgaverne i Google
- ulæst post i Gmail
- ulæst post i mine to firmakonti
- mit CRM: forfaldne opfølgninger, kontakter jeg ikke har talt med længe, og fødselsdage den næste uge
- min liste over gøremål
- jobsøgningen: hvem jeg skal følge op på
- salgspipelinen: hvilke handlinger der forfalder i dag
Hver kilde bliver til en tabel. Tabellerne bliver printet under hinanden. Går en kilde ned, fordi et login er udløbet, står der en rød linje med fejlen, og resten af briefingen kommer alligevel.
Det er hele programmet.
Det, en agent ville gøre
Forestil dig den samme opgave løst med en agent. Den får adgang til de samme otte kilder som værktøjer. Hver morgen læser den en instruktion, beslutter hvilke værktøjer den skal kalde, kalder dem, læser svarene og skriver et resumé.
Det virker. Men se, hvad der er blevet tilføjet.
Den kan vælge anderledes i morgen. Min briefing kalder de otte kilder i samme rækkefølge hver dag. En agent beslutter det hver gang. Oftest beslutter den det rigtige, men »oftest« er en ny egenskab, som opgaven ikke havde i forvejen.
Den kan udelade noget. Et resumé er en udvælgelse. Når agenten skriver »du har et par ulæste mails fra leverandører«, har den valgt, at mailen fra Nykredit om min ansøgning ikke var vigtig nok til at nævne ved navn. Min tabel vælger ikke. Den viser alle rækker.
Den kan finde på noget. Sprogmodeller skriver sandsynlig tekst. En sandsynlig morgenbriefing indeholder et møde kl. 10. Det sker sjældent, men det sker, og i en briefing er det den værste fejl, der findes, fordi hele pointen er, at man kan stole på den uden at tjekke.
Den koster hver dag. Otte kilders rådata sendt gennem en model hver morgen er ikke dyrt i kroner, men det er ikke gratis, og det tager længere tid end seks sekunder.
Den er svær at rette. Når min briefing viser noget forkert, finder jeg linjen. Når en agent viser noget forkert, ændrer jeg en instruktion og håber.
Hvor forskellen ligger
Spørgsmålet er, om opgaven kræver et skøn.
At hente dagens aftaler kræver ikke et skøn. Der findes et API, der svarer på præcis det spørgsmål. At filtrere opgaver, der forfalder i dag eller tidligere, er en sammenligning af to datoer. At finde ulæste mails er et flag, der enten er sat eller ikke sat.
Alt i min briefing er den slags. Skønnet ligger allerede et andet sted: i CRM'et, hvor jeg selv har bestemt, at Oliver skal kontaktes hver 30. dag. I jobsøgningen, hvor reglen om at følge op efter fem dage og højst to gange er skrevet ned som kode. I salgspipelinen, hvor hvert lead har en næste handling og en dato, som jeg har sat.
Når skønnet er truffet på forhånd og skrevet ned, er det, der er tilbage, bare opslag. Og opslag er det, almindelig kode er bedst til.
Jeg brugte faktisk en agent
Det ville være uærligt at udelade det: Jeg byggede briefingen sammen med Claude Code. Jeg bad om modulet, agenten læste mine eksisterende kommandoer, fandt ud af, hvad de returnerede, skrev koden, kørte den mod mine rigtige data og rettede det, der gik galt. Blandt andet havde den kaldt en hjælpefunktion run, som er et reserveret ord i Nushell. Den så fejlen og omdøbte funktionen.
Det er der, agenten hører hjemme: i arbejdet med at bygge noget, hvor der skal læses kode, træffes små valg og rettes fejl. Det arbejde sker én gang.
Briefingen skal køre hver morgen i årevis. Den skal ikke tænke. Den skal gøre det samme som i går.
Fordelingen er den samme som i Jeg kan ikke tale mig uden om en hash: Brug modellen, hvor der skal skønnes, og byg en mekanisme, hvor noget skal gentages pålideligt. En agent, der bygger et program, er en god idé. En agent, der er programmet, bør have en grund til at være det.
Hvor en model ville gøre en forskel
Der er steder, hvor briefingen kunne blive bedre med en model. Mine 20 ulæste mails i Gmail er for det meste kvitteringer og sikkerhedsadvarsler. En model kunne sortere dem i »skal læses« og »kan vente«, og det er et reelt skøn.
Men læg mærke til, hvor det skøn ville sidde. Det ville være ét trin i et program, der ellers er deterministisk: Hent mails, lad modellen give hver mail en kategori, vis dem sorteret. Resten af briefingen ville ikke røre modellen, og hvis modellen var nede, ville der stadig komme en briefing, bare usorteret.
Modellen som en komponent kan man kontrollere. Modellen som den, der styrer det hele, kan man ikke.
Hvad en virksomhed skal tage med
- Spørg, hvilke dele af opgaven der kræver et skøn. Rapporter, overblik, statusmails og dashboards er ofte opslag i systemer, der allerede har et API. Det kan løses med et script, som ikke tager fejl på nye måder.
- Skriv reglerne ned, før I automatiserer. »Følg op efter fem dage« er en regel, som en maskine kan følge uden at gætte. »Hold øje med vigtige kunder« er det ikke.
- Brug gerne en agent til at bygge automatiseringen. Det er et af de steder, hvor den sparer mest tid, fordi resultatet kan testes og derefter kører uden den.
- Når en model skal med, så lad den være ét trin og ikke hele processen. Så kan det resterende stadig køre, og I kan se præcis, hvad modellen besluttede.
Den bedste AI-løsning på en opgave, der ikke kræver intelligens, er ofte et program, som AI har hjulpet med at skrive.
Se Din AI-agent går ned på trin syv. Hvad så? om, hvad der sker, når en agent faktisk skal arbejde over mange trin, og Automatisering om, hvor grænsen går.